NVIDIA выпустила открытую модель Nemotron 3.5 Transcribe
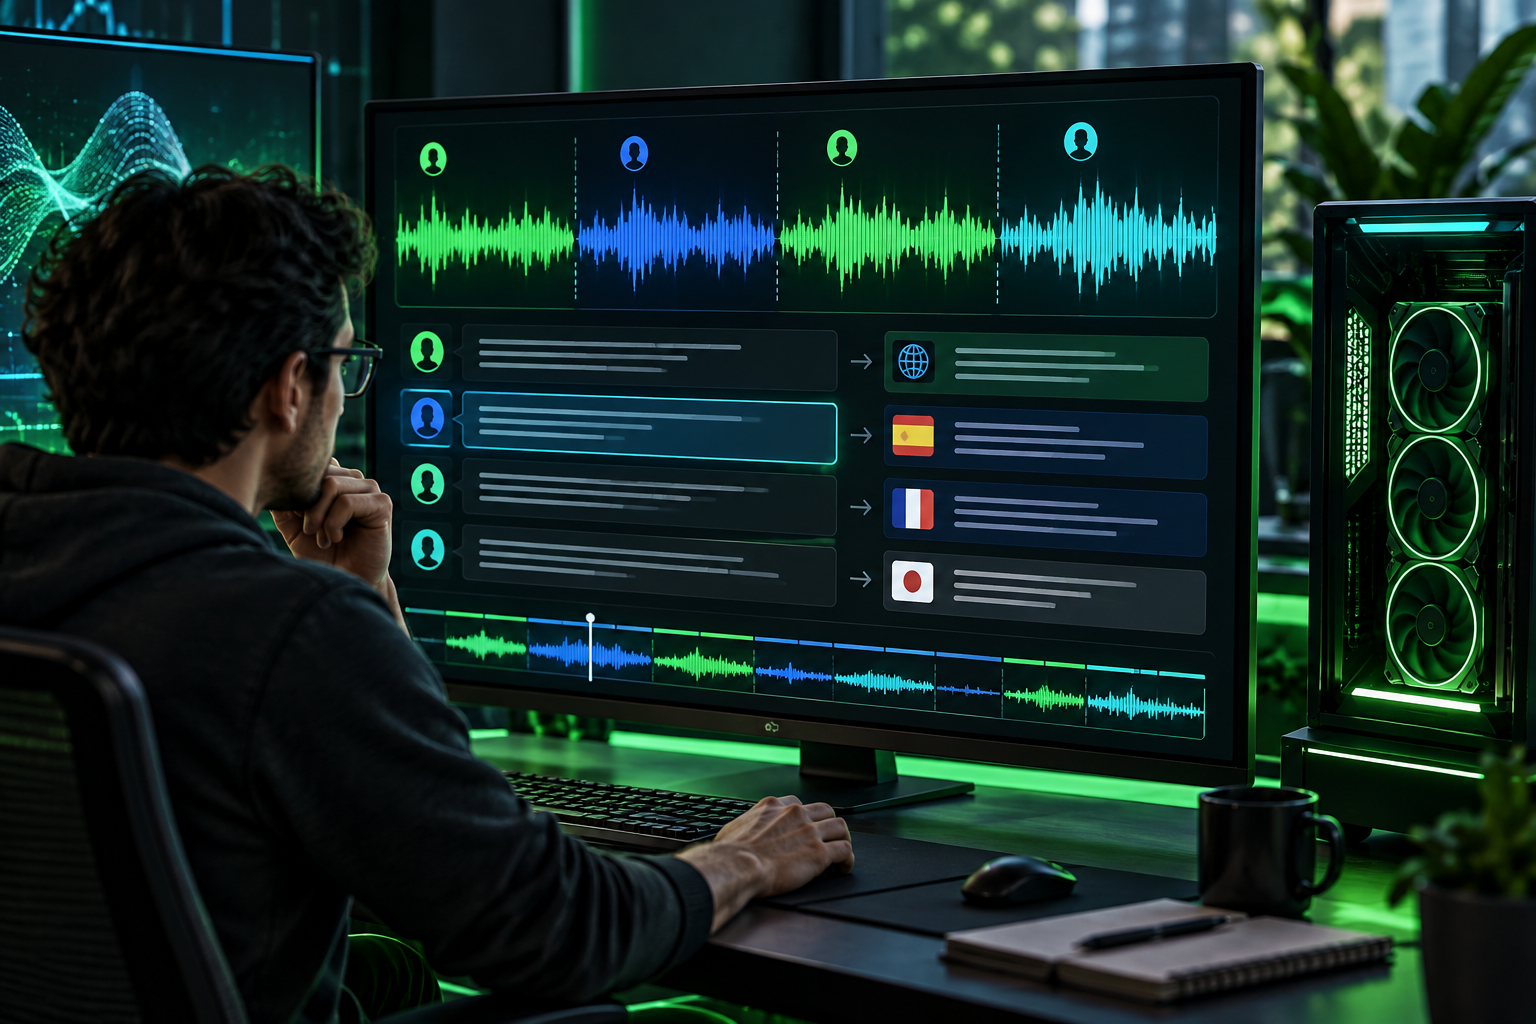
28 октября NVIDIA сообщила о выходе Nemotron 3.5 Transcribe - открытой по весам модели для работы с записанной речью. В одном процессе она должна выполнять распознавание, маркировку говорящих и перевод, а также отвечать на вопросы по аудио. Компания указывает поддержку 40 языков, в том числе семи индийских, и доступность на Hugging Face. Анонс был частью новостей о линейке RTX Spark, но сама публикация весов на Hugging Face не означает, что все варианты модели уже настроены для локального запуска на каждом устройстве.
Что изменилось
Одна модель объединяет несколько задач с аудио
NVIDIA описывает модель как promptable-систему, которая может транскрибировать запись, отмечать говорящих, переводить и извлекать сведения по вопросу. Такой способ работы уменьшает число отдельных этапов в прототипе, но не отменяет необходимости проверить каждую задачу. Ошибка в распознавании может перейти дальше в перевод или сводку, поэтому для критичных записей нужно сохранять исходный аудиофайл и сверяемый текст.
Компания указывает сорок поддерживаемых языков
В анонсе названы 40 языков, включая семь индийских. Реальное качество зависит от языка, акцента, шума, дикции, кодового переключения и доменного словаря. Общая цифра не сообщает точность для каждой комбинации условий. Организациям с многоязычными звонками полезно подготовить собственную размеченную выборку и отдельно проверить имена, номера, отрицания и команды.
Открытые веса меняют варианты размещения
По словам NVIDIA, разработчики могут выбирать, где обрабатывается аудио - на локальном компьютере или в облаке. Но фактическая возможность запуска зависит от лицензии, размера весов, требований к памяти, доступного ускорителя и выбранной реализации. Перед использованием в коммерческом продукте нужно проверить условия лицензии и полную модельную карточку, а также определить, кто отвечает за обновления и уязвимости окружения.
Доступность на Hugging Face отделена от оптимизаций RTX
Компания указывает, что модель доступна на Hugging Face; квантованные версии для RTX Spark и DGX Spark ожидаются позднее. Отдельно упоминаются варианты развертывания через NeMo-Speech.cpp или vLLM. Это разные уровни готовности и интеграции. Пользователю следует сверять конкретный checkpoint, формат, требования и инструкции в первичном репозитории, а не считать все пути установки уже равнозначно доступными.
Рейтинги не заменяют тест на собственных аудиозаписях
NVIDIA сообщает высокие позиции в Open ASR и Artificial Analysis и приводит размер активной части модели. Поскольку это продуктовый анонс, метрики следует трактовать как заявленные оценки на конкретных тестах, а не как гарантированную точность на записи службы поддержки или лекции. Для своего пилота фиксируйте условия записи и тип ошибки, а не только общий процент распознанных слов.
Что это дает пользователю
Открытые веса позволяют рассматривать локальное размещение как один из вариантов.
Объединение распознавания, speaker labeling и перевода может упростить архитектуру прототипа.
Поддержка нескольких языков представляет интерес для команд с международной аудиоколлекцией.
Анонс подсказывает, какие форматы развертывания стоит проверить на имеющемся оборудовании.
Что нужно учитывать
Число языков не равно одинаковому качеству для каждого языка.
Квантованные варианты для RTX Spark и DGX Spark были обозначены как будущие.
Лицензию весов и требования к ресурсам нужно проверить до коммерческого развертывания.
Записи с персональными или конфиденциальными сведениями требуют отдельного режима обработки.
Коротко
Nemotron 3.5 Transcribe связывает несколько операций с речью в одну модель и дает разработчикам вариант работы с открытыми весами. Практический интерес будет зависеть от качества на нужном языке и возможности безопасно запускать модель там, где разрешено хранить запись. Пока опубликованные рейтинги стоит считать ориентирами производителя, а решение принимать по собственным обезличенным примерам и лицензионным условиям. Для практического сравнения команде понадобятся одинаковые исходные записи и правила разметки: шум, акцент, переключение языков, имена, технический словарь и число говорящих. Считайте ошибки по типу, а не только общую долю слов: потерянное отрицание, имя клиента и ошибка пунктуации имеют разные последствия. Если модель работает локально, зафиксируйте оборудование, квантование и задержку на заданной длине записи. Заявленные результаты рейтингов зависят от версии набора и методики, а собственное доменное качество может отличаться. Компания указывает, что квантованные варианты для RTX Spark и DGX Spark будут доступны позднее; это не следует смешивать с доступностью весов модели на Hugging Face, о которой говорится отдельно. До передачи транскрипта в поисковую или аналитическую систему определите, сохраняется ли исходное аудио, сколько времени хранится производный текст и кто может открыть запись по сегменту. Разделение говорящих само по себе не подтверждает личность человека: метки могут перепутаться при перебивании, шуме или короткой реплике. Для медицинских, финансовых и кадровых разговоров назначьте правила проверки и удаления. Если необходима только запись решений, можно передавать в последующий этап проверенную выдержку вместо полного разговора. Этот выбор следует делать по цели обработки и требованиям организации, а не только по стоимости модели.