AWS представила Global Inference Gateway для кластеров HyperPod
20 ноября AWS объявила управляемый шлюз между кластерами SageMaker HyperPod. Межкластерный уровень дополняет выбор GPU-пода внутри отдельного кластера.
Что объявила AWS
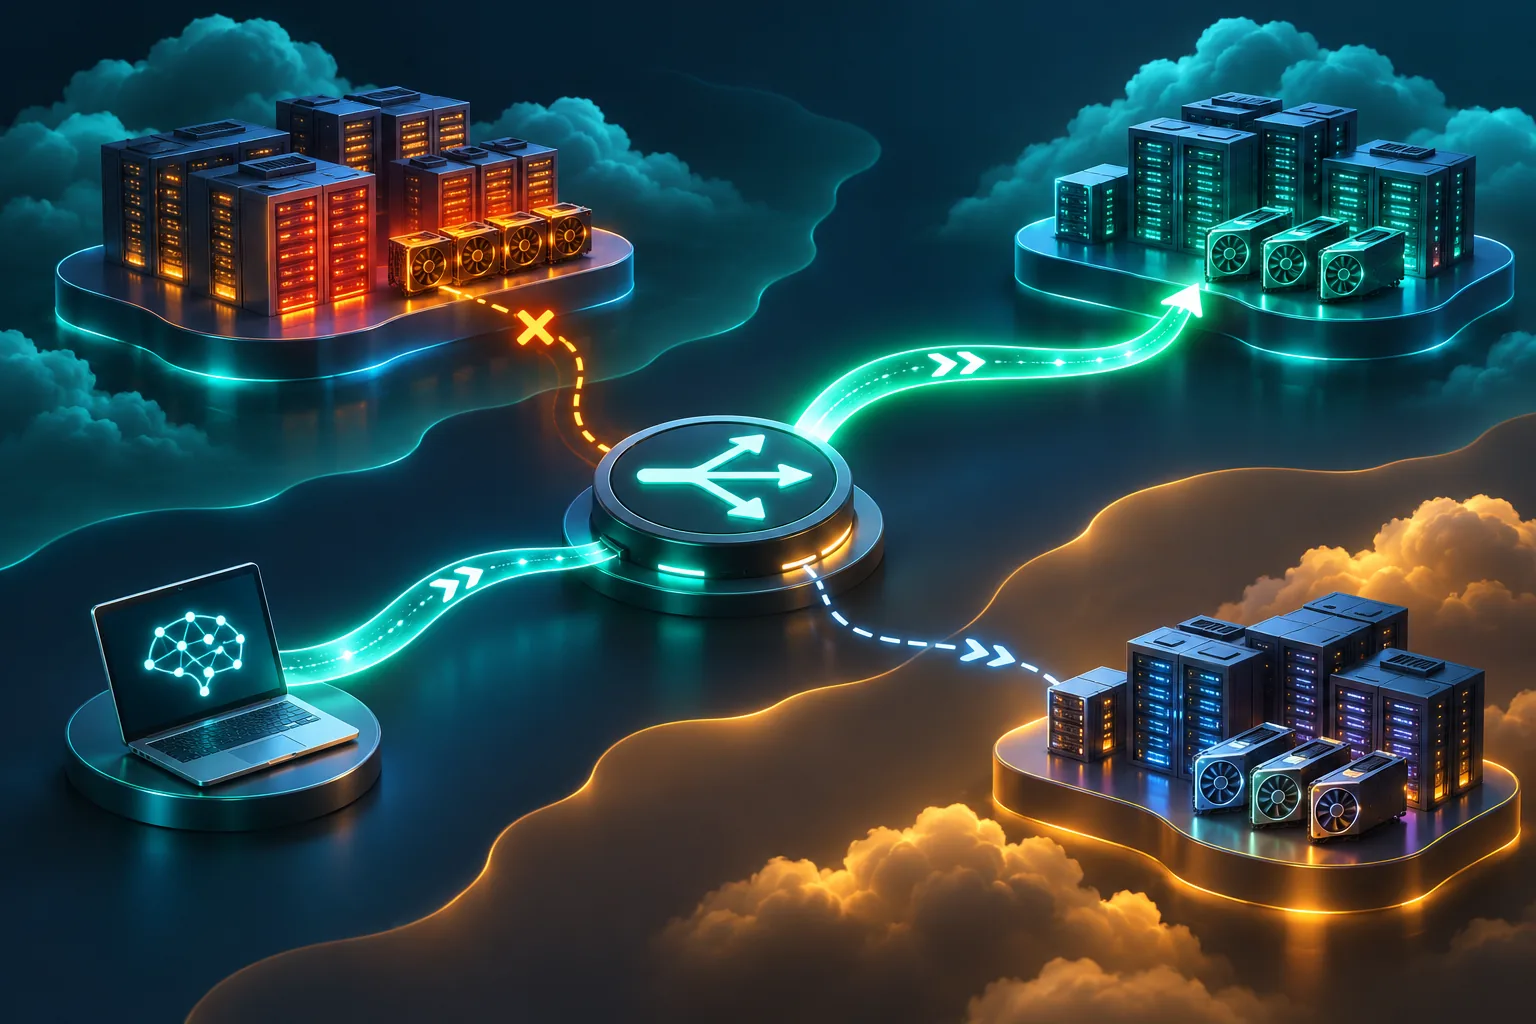
20 ноября AWS представила Global Inference Gateway для Amazon SageMaker HyperPod. Управляемый endpoint маршрутизирует инференс между зарегистрированными кластерами в одном регионе или между регионами. Это второй уровень после Inference Gateway, который выбирает pod внутри кластера.
Если один кластер перегружен, а в другом есть свободная GPU-мощность, клиентскому приложению прежде приходилось самостоятельно знать endpoints и менять маршруты. При отказе площадки могла требоваться ручная настройка. Новый шлюз должен централизовать такой выбор.
Как работает межкластерный уровень
Клиент обращается к одному адресу, а шлюз выбирает кластер и передает запрос. По описанию AWS, межрегиональный трафик проходит по сети компании; сервис поддерживает автоматический failover. Аутентификация выполняется через AWS Signature Version 4 и IAM, соединение кластерами - через AWS PrivateLink.
Внутри целевой площадки прежний Inference Gateway продолжает направлять запрос к pod. То есть новое объявление меняет уровень выбора кластера и не заменяет модель, инфраструктуру GPU или маршрутизатор внутри каждой площадки.
Пример с несколькими моделями
AWS рассматривает команду, обслуживающую четыре модели на пяти кластерах в двух регионах. Без маршрутизатора клиент учитывает двадцать endpoints, по одному для модели и кластера. Inference Gateway сокращает число до пяти, но клиент все еще выбирает кластер. Глобальный уровень призван оставить одну клиентскую точку.
Это упрощает конфигурацию, но не гарантирует свободную емкость, одинаковую задержку или доступность модели на каждом кластере. Перед межрегиональной схемой проверьте требования к местоположению данных, задержкам и стоимости трафика.
Что показали тесты клиента
AWS приводит пример Bagelcode, которая тестировала распределение запросов между двумя регионами и продолжение работы при потере кластера. Это отзыв клиента, а не независимая оценка всех возможных конфигураций.
Проверьте перегрузку очереди, отказ кластера, временную сетевую ошибку и отсутствие нужной модели на резервной площадке. Для долгих потоков важны состояние сессии, идемпотентность и поведение при повторной доставке. Failover может восстановить маршрут, но приложению все еще нужно корректно пережить перебой.
План внедрения
Составьте список кластеров и моделей, разрешенных для единого endpoint, выберите регионы и настройте роли IAM на минимальные права. Уточните сетевой путь и доступность сервиса для вашего аккаунта. Начните с тестового трафика, измерьте p95 latency, очередь, ошибки, GPU-утилизацию и частоту переключений.
Сравните стоимость и клиентскую задержку с обращением к каждому endpoint напрямую. Единый адрес снижает собственную маршрутизационную работу, но не отменяет управление емкостью и отказами. Анонс описывает AWS HyperPod, а не универсальный механизм для любых облачных моделей.
Проверка до переключения
В тестовой среде создайте нагрузку, перегрузите одну очередь, отключите кластер и сравните восстановление с прямым endpoint. Проверьте отсутствие модели на резерве и повторную доставку потока. Измеряйте p95 latency, ошибки, время failover и цену трафика между регионами.
Сверьте разрешенные регионы, IAM, PrivateLink и требования к хранению. Единый адрес сокращает клиентскую конфигурацию, но не отменяет планирование емкости и поведение сессии при отказе.
Как проверить отказоустойчивость
В тестовой среде перегрузите одну очередь, отключите кластер и проверьте продолжение запросов на резерве. Отдельно убедитесь, что нужная модель и версия артефакта существуют на резервной площадке. Измеряйте время обнаружения, частоту ошибок, клиентскую задержку, очередь GPU и стоимость трафика.
Streaming и повтор требуют особого сценария. Для действия с побочным эффектом обеспечьте идемпотентность, чтобы перенаправление не выполнило его дважды. Сопоставляйте журналы шлюза с клиентскими ID запросов.
Ограничения по регионам
Перед межрегиональным маршрутом проверьте требования к местоположению документов и prompts. Уточните, куда запрос попадет при отказе основного кластера, и сможет ли сервис оставить его в разрешенной области. Резервная площадка должна поддерживать те же ограничения и минимальные права IAM.
Зафиксируйте критерии переключения, возврата трафика и емкость каждой площадки. Единый endpoint уменьшает собственную маршрутизационную логику, но не отменяет управление мощностью, наблюдаемость и эксплуатационную процедуру.
Наблюдаемость после запуска
Соберите одну панель, где видны выбранный кластер, регион, очередь, GPU utilization, latency и причина переключения. Без этого рост p95 трудно объяснить: его вызвала перегрузка, сеть, смена площадки или повтор запроса. Сопоставляйте данные уровня gateway и endpoint с request ID приложения.
Установите оповещения на дисбаланс и постоянную нагрузку на резерв. Если резерв всегда пустой из-за правила маршрутизации, заявленная экономия мощности не достигнута. Если он регулярно перегружается после failover, уменьшите допустимую долю входящего трафика или добавьте capacity.
Проверьте, как при плановых обновлениях кластеры исключаются из маршрутизации и возвращаются после проверки здоровья. Этот процесс столь же важен, как аварийный сценарий.
Критерии готовности
Перед включением задайте целевой максимум ошибки и допустимый срок переключения, а затем проверьте их на тестовых отказах. Зафиксируйте, какие регионы могут быть резервом, кто подтверждает запуск и какие модели должны присутствовать на каждом кластере. Страница статуса должна показывать, если резервная емкость меньше оговоренного уровня.
После запуска делайте периодическую тренировку: временно исключайте тестовую площадку, проверяйте сигнал здоровья и возвращайте ее после синхронизации. Выявленные расхождения фиксируйте вместе с версией конфигурации. Без регулярного упражнения команда может впервые обнаружить сломанный failover во время реального отказа.
Источник и дата события
Событие объявлено 20 ноября 2026 года. технический анонс AWS о Global Inference Gateway: официальная публикация.