AWS добавила в SageMaker подготовку данных для обучения и оценки моделей
17 ноября AWS объявила о наборе средств AI Data Preparation в Amazon SageMaker AI. Он объединяет генерацию синтетических примеров, автоматическую разметку, экспертную проверку, оценку качества и преобразование датасета. По сообщению компании, функции доступны в регионах US East (N. Virginia) и US West (Oregon), а работать с ними можно через Python SDK и инструменты для IDE.
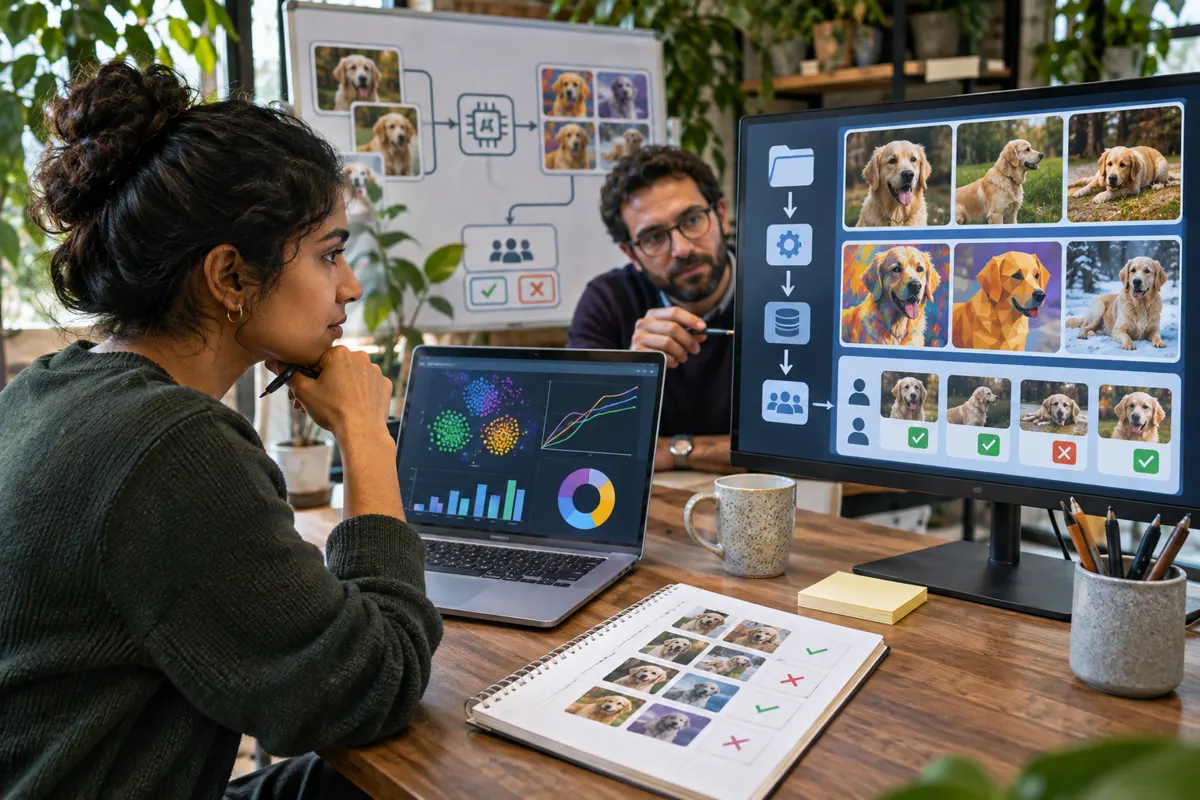
Какие этапы объединяет набор
AWS представила пять блоков: автоматическая разметка, очередь экспертной проверки, генерация синтетических данных, оценка качества и преобразование формата. Разработчик может использовать каждый блок отдельно или соединить несколько шагов в собственный процесс. Для описания задачи предлагается спецификация, которую можно просмотреть и изменить; ее можно запускать через SageMaker Python SDK или с помощью AI-ML skill в поддерживаемой среде разработки.
Разметка и очередь экспертной проверки
В автоматической разметке поддерживаются задачи классификации, извлечения именованных сущностей, извлечения ответов из контекста, порядковой оценки и суммаризации, а также описываемые пользователем виды задач. Для некоторых типов фиксированных ответов система использует несколько моделей и выставляет оценку согласия. Записи ниже выбранного порога уверенности могут попадать в очередь проверки в SageMaker Studio. Экспертные исправления возвращаются в процесс и могут использоваться для подготовки отчета по качеству разметки.
Синтетические примеры и проверка данных
Синтетическую выборку можно генерировать по спецификации и привязывать к исходным документам или примерам. Встроенная оценка ищет дубликаты и похожие записи, шумные метки, утечку правильного ответа и другие отклонения по заданным правилам и метрикам. AWS также описывает возможность преобразовывать записи: объединять, делить, фильтровать, удалять повторы или менять формат. Генерация не отменяет проверку того, что новые примеры действительно представляют нужные случаи, а не только повторяют стиль исходного набора.
Как встроить инструменты в рабочий процесс
Команда задает тип задачи, входные данные, критерии качества и допустимый уровень уверенности. Затем сначала формируется небольшая выборка, которую проверяют специалист и владелец задачи. После корректировки спецификации запускается более крупная обработка, результат повторно оценивается и только после этого включается в тренировочный или оценочный набор. Если задача связана с ответами по инструкции, нужно отдельно проверять, что примеры не добавляют деталей, которых нет в источнике, и что тестовые ответы не просачиваются в обучающую часть.
Контроль данных и доступа
По сообщению AWS, исходные данные, сгенерированные датасеты и метки остаются в управляемых клиентом бакетах Amazon S3, а выполнение опирается на IAM-роль организации. Это полезная граница, но не автоматическая гарантия безопасности: нужно проверить права роли, журналирование, регион хранения, срок удержания копий и доступ экспертов. Если для разметки подключаются внешние рецензенты, проверьте, какие поля им доступны и как сохраняются их комментарии.
География и статус запуска
AWS обозначила общую доступность набора в двух регионах США: Северная Вирджиния и Орегон. В сообщении не указано, что функции работают во всех регионах или что каждый поддерживаемый вид преобразования доступен через одинаковый интерфейс. Командам за пределами этих регионов стоит проверить текущую документацию, ограничения аккаунта и маршрут данных до начала переноса датасетов. В анонсе также не раскрываются отдельные цены на все операции, поэтому стоимость следует оценить по применяемым сервисам и объему обработки.
Как оценить пользу без завышенных ожиданий
Сравнивайте ручную подготовку и новый процесс на одной и той же задаче: время на спецификацию, доля корректных меток в экспертной выборке, число дубликатов, доля записей ниже порога, стоимость разметки и количество исправлений после обучения. Разделяйте синтетические и исходные примеры, чтобы не смешивать их вклад. Автоматическая оценка может ускорить поиск проблем, но критерии приемки и решение о пригодности набора для конкретной модели остаются за командой.
Где проходит граница между автоматизацией и проверкой
Согласие нескольких моделей может помочь расставить приоритеты, но одинаковая ошибка у нескольких моделей остается ошибкой. Проверяйте редкие классы, неоднозначные инструкции, примеры с отрицанием и ответы, где важен небольшой фрагмент документа. Для экспертной очереди задайте отдельный процесс разрешения расхождений и храните исходный пример, спецификацию и версию разметки вместе. Иначе невозможно понять, вызвано ли изменение метки новой инструкцией или моделью.
Синтетические данные полезны для покрытия редких сценариев, но не должны вытеснять реальные случаи, если распределение в эксплуатации отличается. Сравните признаки исходной и сгенерированной выборки, проверьте дубли и утечку между обучающей и тестовой частью. Критерий пригодности зависит от конечного применения: набор для оценки требует особенно строгой защиты ответов от попадания в подсказки или обучающий корпус.
Что это значит на практике
Командам, которые уже хранят данные в S3, стоит начать с проверки региона, роли IAM и стоимости выбранных шагов. Если данные доступны в других хранилищах, заранее уточните поддерживаемый путь импорта и не копируйте чувствительные массивы в обход политики. Для пилота достаточно ограниченного набора с контрольной разметкой; успешная генерация большого числа строк сама по себе не означает готовности данных к обучению.
Источник и дата события
Событие объявлено 17 ноября 2026 года. Анонс AWS AI Data Preparation: официальная публикация.
AWS объединяет несколько операций подготовки набора, сохраняя возможность просмотреть спецификации и код. Заявленная доступность ограничена двумя регионами США, а качество результата требует экспертного контроля.